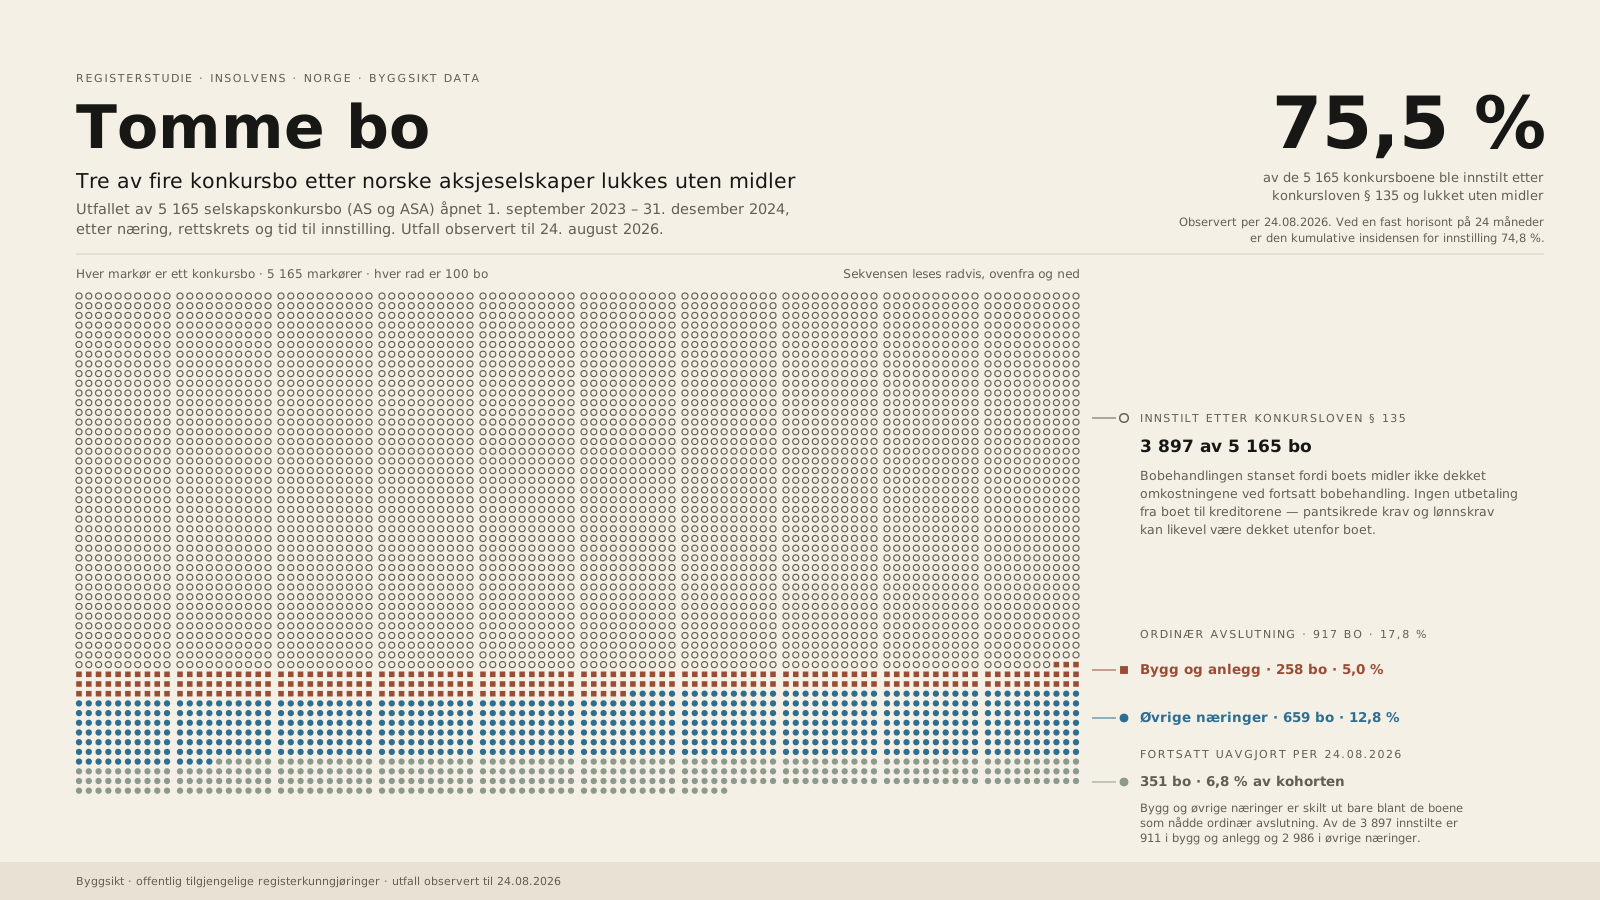
ROC-AUC 0,883, AP 0,411 og statistisk støttet forbedring mot den frosne referansen på de integrerte rangeringsmålene.
Kalibrering-i-det-store feilet, og utfallsvinduet for FY2024 er ikke fullt modent før 31. desember 2026.
Bakgrunn: Modeller for kredittrisiko kan oppnå høye skårer av feil grunner. Vanlige feilkilder er utfallsbetinget kohortseleksjon, regnskapsdata som ikke var offentlig tilgjengelige på prediksjonstidspunktet, overlappende utfallsvinduer, samtidige registerbilder og felt som indirekte røper om et selskap senere ble slettet. Vi utviklet derfor en modellprosess der tidsrekkefølge og kildeproveniens ble behandlet som en del av den statistiske modellen, ikke som etterfølgende datavask.
Metode: En egenkurert, longitudinell samling av offentlig tilgjengelige norske register-, regnskaps- og kunngjøringsopplysninger ble strukturert rundt et fast prediksjonstidspunkt: 31. desember i regnskapsåret. Utfallet var konkursåpning eller tvangsoppløsning de neste 24 månedene. Modellen er et ensemble av ti gradientforsterkede beslutningstrær med 214 datadrevne variabler og én deterministisk kanarivariabel. Utvikling og intern validering ble separert på selskapsnivå; FY2024 ble brukt som senere ut-av-tid-evaluering. Forbedringen mot en frosset 198-variabelreferanse ble undersøkt med 1 000 parrede selskapsbootstrap-trekk.
Resultater: På 375 688 FY2024-selskaper med 8 082 observerte utfall oppnådde ensemblet ROC-AUC 0,883, gjennomsnittlig presisjon 0,411 (AP — i praksis arealet under presisjon–sensitivitetskurven, ofte omtalt som PR-AUC), standardisert partiell ROC-AUC ved falsk-positiv-rate opptil 10 prosent på 0,768 og Brier-skår 0,0161. Topp 1, 5 og 10 prosent av rangeringen fanget henholdsvis 29,10, 55,85 og 67,03 prosent av utfallene. Mot referansen var forskjellen i ROC-AUC +0,0037 (95 prosent konfidensintervall +0,0029 til +0,0047) og i AP +0,0132 (+0,0099 til +0,0163). Seed 42 lot seg gjenskape bit-for-bit.
Fortolkning: Evidensen støtter sterk temporal rangering og en statistisk robust inkrementell forbedring. Den støtter ikke ennå bruk som ferdig absolutt 24-måneders sannsynlighet: observert/forventet-forholdet var 1,62 — en nedre grense inntil vinduet er fullt modent — og den forhåndsdefinerte kalibrering-i-det-store-porten ble ikke bestått. FY2024-utfallet var dessuten observert til 24. august 2026, mens hele 24-månedersvinduet lukkes 31. desember 2026. Studien dokumenterer dermed en sterk utviklingskandidat for risikorangering og kontrollert skyggetesting, ikke et ubetinget bevis for autonom kredittbeslutning.
Abstract (English)Read the English abstract
Background: Credit-risk models can score well for the wrong reasons. Common failure modes include outcome-conditioned cohort selection, accounts that were not yet public at prediction time, overlapping outcome windows, contemporaneous registry snapshots, and fields that indirectly reveal whether a company was later deleted. We therefore built a modelling process in which temporal order and source provenance are treated as part of the statistical model itself, not as downstream data cleaning.
Methods: A proprietary, curated longitudinal reconstruction of publicly available Norwegian registry, annual-accounts and gazette data was anchored to a fixed prediction origin: 31 December of the accounting year. The outcome was bankruptcy opening or forced dissolution within the following 24 months. The model is an ensemble of ten gradient-boosted decision trees over 214 data-driven features plus one deterministic canary. Development and internal validation were separated at the company level; FY2024 served as a later out-of-time evaluation. The improvement over a frozen 198-feature reference was examined with 1,000 paired company-bootstrap draws.
Results: On 375,688 FY2024 companies with 8,082 observed failures, the ensemble reached ROC-AUC 0.8830, average precision (AP — in effect the area under the precision–recall curve, often labelled PR-AUC) 0.4112, standardised partial ROC-AUC at a false-positive rate of up to 10 percent of 0.7680, and a Brier score of 0.0161. The top 1, 5 and 10 percent of the ranking captured 29.10, 55.85 and 67.03 percent of the failures respectively. Against the reference, the difference in ROC-AUC was +0.0037 (95 percent confidence interval +0.0029 to +0.0047) and in AP +0.0132 (+0.0099 to +0.0163). Seed 42 replayed bit-exactly.
Interpretation: The evidence supports strong temporal ranking and a statistically robust incremental improvement. It does not yet support use as a finished absolute 24-month probability: the observed/expected ratio was 1.6216 — a lower bound until the window matures — and the pre-declared calibration-in-the-large gate failed. Moreover, the FY2024 outcome was observed up to 24 August 2026, while the full 24-month window closes on 31 December 2026. The study thus documents a strong development candidate for risk ranking and controlled shadow testing, not an unconditional basis for autonomous credit decisions.
1. Problemstilling og vitenskapelig bidrag
Konkurs er et sjeldent, tidsavhengig og administrativt registrert utfall. Det gjør oppgaven mer krevende enn ordinær binær klassifikasjon. En modell kan rangere godt fordi den faktisk oppdager økonomisk svekkelse, men også fordi den har fått se et registerspor som først oppstod etter konkursen, fordi de vanskeligste selskapene aldri kom inn i kohorten, eller fordi samme terminale hendelse ligger både i trenings- og evalueringsvinduet. En høy ROC-AUC er derfor ikke i seg selv et bevis på at en modell måler fremtidig risiko.
Vår studie stiller tre spørsmål. For det første: hvor godt kan en modell rangere konkurs eller tvangsoppløsning innen 24 måneder ved hjelp av informasjon som prinsipielt var tilgjengelig på et felles historisk skjæringspunkt? For det andre: overlever resultatet målrettede forsøk på å falsifisere signalet, blant annet tidsporter, kildeforbud, duplikatkontroller, blokkomstokking og en eksakt reproduksjon? For det tredje: gir rangeringen praktisk konsentrasjon av utfall når undersøkelseskapasiteten er begrenset til de høyest rangerte 1, 5 eller 10 prosentene?
Bidraget er først og fremst metodisk. Vi behandler datagrunnlag, kohort, etikett og modell som ett sammenhengende målesystem. Det er avgjørende fordi prediktiv ytelse ikke bare er en egenskap ved algoritmen; den er en egenskap ved hele kjeden fra offentlig hendelse til tidsstemplet variabel og til slutt evaluert prediksjon. Denne tankegangen følger den grunnleggende åpenheten i TRIPOD-rammeverket: en prediksjonsstudie må beskrive deltakere, prediktorer, utfall, validering og analyse så presist at resultatets anvendelighet og risiko for skjevhet kan vurderes.
Studien er ikke en sammenlikning med banker eller kommersielle kredittopplysningsprodukter. Vi har ikke tilgang til deres identiske porteføljer, utfallsdefinisjoner, tidspunkter eller beslutningskostnader, og en slik påstand ville derfor ikke være etterprøvbar. Resultatene gjelder den definerte norske AS/ASA-kohorten, det definerte 24-månedersutfallet og den frosne evalueringen beskrevet her. Kohorten omfatter alle norske aksje- og allmennaksjeselskaper som var risikoutsatte ved origin, ikke bare småforetak; sidens URL gjenspeiler et tidligere arbeidsnavn.
2. Datagrunnlag og historisk utfallsrekonstruksjon
Datagrunnlaget er Byggsikts egen kuraterte og kvalitetssikrede rekonstruksjon av offentlig tilgjengelige norske register-, regnskaps- og kunngjøringsopplysninger. Kildene omfatter virksomhetsopplysninger, innsendte årsregnskap og daterte kunngjøringer fra Brønnøysundregistrene. Innsamlingsinfrastrukturen, den deterministiske dokumenttolkningen og enkelte søkeprosedyrer er proprietære. Den vitenskapelige beskrivelsen oppgir likevel kildekategori, tidsavgrensning, logisk de-duplisering, transformasjon, radtall og kryptografiske fingeravtrykk for modellbidragene.
Brønnøysundregistrene beskriver Regnskapsregisteret som en sentral kilde til innsikt i den økonomiske tilstanden i norsk næringsliv. Årsregnskap er offentlige, men de representerer et rapporteringsforløp: regnskapsåret avsluttes, regnskapet fastsettes, sendes inn og godkjennes senere. Den ordinære fristen for å unngå forsinkelsesgebyr er 31. juli året etter. Et regnskap for FY kan derfor ikke uten videre behandles som kjent 31. desember i FY. Konkret inngår bare regnskapsår til og med FY−1 som finansiell prediktorinformasjon ved origin 31. desember i FY. Der et godkjennings- eller innsendingstidspunkt er observert i kunngjøringene, kreves det i tillegg at dette ligger på eller før origin; for historiske verdier uten slikt bundet tidspunkt hviler tidsriktigheten på FY−1-forskyvningen alene. Restrisikoen ved manglende dokumentnivå-proveniens behandles i kapittel 10.
Utfallet ble rekonstruert fra daterte offentlige kunngjøringer om konkurs og tvangsoppløsning. Konkursregisterets kunngjøringer inneholder blant annet organisasjonsnummer, åpningsdato, saksnummer og rettslig instans, og publiseres normalt samme dag som åpningen. Vi bruker hendelsesdato og organisasjonsnummer til å etablere terminal kronologi. Frivillig avvikling, fusjon og fisjon behandles som konkurrerende utganger, ikke som overlevende eller som konkurs. Et selskap som allerede hadde et terminalt utfall før prediksjonsdatoen, inngår ikke som et risikoutsatt selskap ved den datoen.
Historisk rekonstruksjon var nødvendig fordi samtidige virksomhetsregistre ikke alene representerer fortidens risikopopulasjon. Selskaper som er slettet etter konkurs, kan mangle rike felt i et senere registeruttrekk. Dersom kohorten krever et slikt felt for å bli inkludert, fjernes nettopp mange av de raskeste og vanskeligste konkursene. Vi gjorde derfor kohortinngang uavhengig av regnskapstilgjengelighet. Manglende observasjon håndteres i selve variabelprosessen; den brukes ikke som begrunnelse for å fjerne selskapet fra populasjonen.
Et annet problem er dupliserte fysiske kunngjøringsrader. Telle- og aktualitetsvariabler ble derfor bygget etter kanonisk de-duplisering på logiske hendelsesnøkler. En duplikat skal verken flytte datoen for siste hendelse eller øke antallet hendelser. For familier der samme dag kan inneholde motstridende tilstander, anvendes en konservativ ukjent-tilstand fremfor å velge en gunstig rekkefølge som ikke kan dokumenteres.
| Kildekategori | Tidsrolle | Bruk i studien | Hovedkontroll |
|---|---|---|---|
| Virksomhetsregister | Historiske identitets- og statusopplysninger | Kohortnøkler og stabile selskapsattributter | Ingen samtidige «levende/slettet»-fingeravtrykk som modellvariabel |
| Årsregnskap | FY−1 eller eldre ved origin | Nivåer, kvalitet og robuste finansielle transformasjoner | Forskyvning, før-origin-evidens og kildejustert omstokking |
| Foretaks- og regnskapskunngjøringer | Dato ≤ 31.12.FY | Aktualitet, kapital, revisor, roller og endringer | Fysisk datoport, kanonisk de-duplisering og fremtidsappend-test |
| Konkurskunngjøringer | Dato > origin og ≤ origin + 24 måneder | Kun utfallsrekonstruksjon | Forbudt i prediktorhistorikk |
3. Estimand, kohort og tidsakse
Estimanden er sannsynligheten for at selskapets første observerte konkursåpning eller tvangsoppløsning inntreffer i løpet av de 24 månedene etter 31. desember i et gitt regnskapsår. Studien validerer primært den relative rangeringen av denne sannsynligheten; det absolutte nivået vurderes separat mot forhåndsdefinerte kalibreringsporter i kapittel 8, og bestod ikke. Prediksjonsdatoen kalles origin. Hver variabel må kunne knyttes til informasjon med dato på eller før origin. En terminal hendelse etter origin er et utfall; den samme hendelsen kan aldri samtidig være historikk i prediktorene.
Y(i,t) = 1 dersom Tsvikt,i ∈ (31.12.t, 31.12.(t+2)] og ingen konkurrerende utgang inntreffer først; ellers Y(i,t) = 0 når hele observasjonsvinduet er kjent.For FY2024 er observasjonsvinduet ennå ikke fullt kjent: selskaper uten registrert hendelse per 24. august 2026 er i denne rapporten midlertidig kodet Y = 0. Denne høyresensureringen behandles i kapittel 10.
Kohorten søker å representere aksjeselskaper som var risikoutsatte ved origin. Den er derfor ikke betinget på om et årsregnskap finnes i et senere uttrekk. Dette punktet er viktig: et krav om regnskapsrad kan se nøytralt ut, men selskaper som faller tidlig rekker ofte ikke å levere neste regnskap. Da blir «har regnskap» en seleksjon på fremtidig overlevelse. I denne studien beholdes selskapet, mens utilgjengelige verdier håndteres med en fit-only-prosess uten modellvendte deknings- eller kildeflagg.
Konkurrerende terminale utganger håndteres kronologisk. Dersom frivillig avvikling, fusjon eller fisjon inntreffer før konkurs eller tvangsoppløsning, regnes utfallet som ikke inntruffet i vinduet (Y = 0): den konkurrerende utgangen utelukker svikt, og selskapet forblir i nevneren. Estimanden er dermed kumulativ insidens av svikt som første terminale hendelse — en konkurrerende-risiko-håndtering, ikke sensur. Ordet sensur reserveres for observasjoner der vinduet ikke er ferdig observert, som det administrativt uferdige FY2024-vinduet: der er utfallet ukjent, ikke kjent negativt. Dersom svikt skjer først, er utfallet positivt. Prinsippet hindrer at et selskap både regnes som konkurrerende utgang og senere som positivt på grunn av en vilkårlig prioritet mellom kolonner. Den formelt forbedrede kronologiske etikettkoden gir en svært liten forskjell mot etikettversjonen som produserte det frosne resultatet; dette oppgis som en reproduserbarhetsbegrensning i kapittel 10.
Én klokke for prediktorer, én senere klokke for utfall
Finansielle observasjoner forskyves bak origin. Ingen FY-regnskapsverdi antas kjent ved avslutningen av samme FY.
Roller, revisor, kapital og endringer kuttes fysisk ved origin og de-dupliseres.
Selskapet rangeres med informasjon som var tillatt på dette tidspunktet.
Konkursåpning eller tvangsoppløsning gir positivt utfall; konkurrerende utgang håndteres først-i-tid.
FY2024 er ennå ikke fullt modent: resterende vindu frem til 31.12.2026 er høyresensurert i denne rapporten.
Utviklings-, validerings- og evalueringsroller
Den frosne kjøringen brukte 300 863 selskaper til modelltilpasning og 33 236 selskaper til intern validering; 765 valideringsselskaper hadde et positivt utfall. Splittingen var deterministisk på organisasjonsnummer, slik at samme selskap ikke forekom på begge sider av fit/val-grensen. Dette hindrer at gjentatte selskapsår eller stabile selskapskjennetegn lekker mellom de to rollene. FY2024-evalueringen bestod av 375 688 selskaper og 8 082 registrerte utfall.
Med 24 måneders horisont overlapper utfallsvinduet for den siste utviklingsårgangen (FY2023) delvis med FY2024-vinduet: begge inneholder kalenderåret 2025, og samme terminale hendelse kan dermed være både treningsetikett og evalueringsutfall for samme selskap. Den frosne kjøringen anvendte ingen purge eller embargo mot dette overlappet; den senere korrigerte etikettkoden innfører en slik purge, men inngår ikke i det frosne resultatet. Overlappet må derfor regnes som en optimismekilde i evalueringen, på linje med begrensningene i kapittel 10. Radtallene for overlappet hører hjemme i en fremtidig versjon av evidensfilen før de siteres.
FY2024 er tidsmessig senere enn utviklingsmaterialet og er derfor en ut-av-tid-evaluering. Den er ut-av-tid, ikke ut-av-selskap: et selskap som inngår i utviklingsmaterialet med tidligere regnskapsår, inngår også i FY2024-kohorten med sitt FY2024-år. Selskapsdisjunktheten gjelder fit/val-grensen innen utviklingsmaterialet. Generaliseringen som testes, er dermed til en senere tidsperiode for en i hovedsak overlappende bestand, ikke til usette selskaper. FY2024 er heller ikke en uberørt ekstern bekreftelseskohort: flere utviklingsvalg ble over tid vurdert mot dette året. Konfidensintervallene i denne artikkelen beskriver derfor usikkerheten i den frosne, parrede sammenlikningen; de inkluderer ikke hele usikkerheten fra den tidligere adaptive modelljakten. En genuint blind bekreftelse krever en ny tidskohort eller en uavhengig portefølje som først åpnes etter at arkitektur, etikett og analyseplan er låst.
| Rolle | Selskaper | Utfall | Bruk |
|---|---|---|---|
| Fit | 300 863 | Ikke publisert som hovedestimat | Tilpasning av trær og fit-only-imputasjon |
| Validering | 33 236 | 765 | Tidlig stopp og kalibrator, helt adskilt på selskap |
| FY2024 evaluering | 375 688 | 8 082 | Senere temporal ytelse og parret sammenlikning |
4. Variabelarkitektur: mekanismer fremfor feltjakt
Den frosne kandidaten har 215 innganger: 214 datadrevne variabler og én deterministisk pseudotilfeldig kanari. Kanarien er en fast, utfallsuavhengig funksjon av stabile selskapsnøkler — bit-reproduserbar og per konstruksjon uten økonomisk informasjon; den er et auditverktøy. De datadrevne variablene er organisert i familier med en forklarbar mekanisme: betalingsevne og kapitalbuffer, regnskapskvalitet, endringsintensitet og aktualitet, selskapsalder, revisorhistorikk, næring og historiske forbindelser mellom personer og andre selskaper.
Regnskapsblokken er størst. Nivåvariabler bevarer informasjon som kan forsvinne i bare forholdstall, mens kvalitetsvariabler beskriver konsistens og struktur i de tilgjengelige regnskapsobservasjonene. En separat kontroll viste at en ny beregning av 14 tradisjonelle forholdstall nesten ikke forbedret treet; fleksible trær kunne i stor grad danne de samme delingene fra nivåene. Det betyr ikke at regnskap er uviktig. Tvert imot viste en kildejustert omstokking av den historiske regnskapsblokken at selskapsspesifikke verdier bar stor prediktiv informasjon. Det negative funnet gjelder redundant transformasjon, ikke selve regnskapskilden.
Aktualitetsvariablene måler hvor mange dager som har gått siden bestemte typer daterte kunngjøringer. Tidligere eksperimenter med en sekvensmodell fant ingen stabil merverdi over en enkel telle- og aktualitetsrepresentasjon. Det nyttige funnet var at «dager siden» konsekvent var mer informativt enn bare «antall». Den frosne arkitekturen bruker derfor en transparent, aggregert hendelseshistorikk fremfor å beholde en volatil sekvensmodell som ikke slo sin egen baseline.
Person- og revisornettverk kan være sterke, men er også farlige. Et samtidig rolleøyeblikksbilde tatt flere år senere røper hvem som fortsatt var aktiv og dermed indirekte hvem som overlevde. Vi bruker bare daterte rollehendelser før origin, identifiserer personer innen hvert historisk tidspunkt og utfører leave-one-out mot selskapet som skal skåres. Historikk basert på konkursåpninger er forbudt som prediktor, både fordi utfallet selv kan lekke og fordi offentlig retensjon av konkurshistorikk varierer over kalenderen. Nettverkssignaler bygges i stedet fra daterte, ikke-terminale varselhendelser med bedre tidsdekning.
Næring representeres fra punkt-i-tid-formålstekst og offisiell klassifikasjon uten å mate modellens klassifikatorsikkerhet inn som egen variabel. Det siste er et viktig designvalg: sikkerheten i en tekstklassifikator kan måle hvor lik teksten er den populasjonen klassifikatoren ble trent på, og dermed bli et skjult overlevelsessignal. Kandidaten bruker næringsinformasjon, men ikke en margin som hevder å vite når næringsgjetningen er «sikker».
| Familie | Antall | Økonomisk eller administrativ mekanisme |
|---|---|---|
| Kontroll og grunnvariabler | 53* | Kohortstabile grunnsignaler, næringsrepresentasjon og én deterministisk kanari |
| Hendelsesaktualitet | 31 | Tid siden daterte endringer, varsler og administrative hendelser |
| Historisk personnettverk | 9 | Før-origin-forbindelser til andre selskaper og varselhistorikk, leave-one-out |
| Regnskapsnivåer | 75 | Likviditet, kapitalstruktur, lønnsomhet, størrelse og resultat |
| Regnskapskvalitet | 30 | Intern struktur og observerbar kvalitet i historiske regnskapsverdier |
| Kapitalhistorikk | 9 | Nivå, endring, minimumskapital og daterte kapitalhendelser |
| Alder og revisorkjerne | 5 | Observert historisk alder, revisorskifte og eksplisitt revisorklarering |
| Revisornettverk, provisorisk | 3 | Daterte oppdragsforhold og andre kjente klienters varselaktualitet |
* De 53 kontroll- og grunnvariablene inkluderer én deterministisk kanari. Kandidaten har dermed 214 datadrevne variabler, ikke 215 selvstendige økonomiske signaler.
Manglende regnskap: observasjonsproblem, ikke automatisk økonomisk egenskap
Manglende regnskapsverdier kan skyldes at selskapet ikke leverte, at den offentlige historikken er begrenset, at dokumentet ble innhentet gjennom en annen historisk kanal, eller at et felt ikke er relevant. Dersom modellen får et eksplisitt «kilde»-, «hentet»- eller «gjenfunnet»-flagg, kan den lære datainnsamlingsprosessen i stedet for kredittrisiko. Slike modellvendte provenance- og dekningsflagg er derfor fjernet.
Numeriske hull fylles deterministisk fra donorer som bare velges i fit-populasjonen, primært innen næringsgruppe, og uten å lese etiketten. Observerte celler bevares. Dette hindrer at evalueringsdata påvirker imputasjonen og gjør manglendehetsbehandlingen nøytral med hensyn til utfallet. Metoden er likevel ikke lik multippel imputasjon og uttrykker ikke full usikkerhet om hvert manglende tall. Robustheten vurderes derfor også ved omstokking og sammenlikning mot en uavhengig regnskapspanel på overlappende selskaper.
5. Modell og treningsdesign
Modellfamilien er gradientforsterkede beslutningstrær for binært utfall. Trær er velegnet når finansielle nivåer, hendelsesaktualitet og nettverkssignaler har terskler og interaksjoner som ikke nødvendigvis er lineære. Arkitekturen ble frosset før den endelige 10-seeds-kjøringen. Hvert medlem brukte 63 blader, læringsrate 0,05, 80 prosent tilfeldig variabelutvalg per iterasjon, 80 prosent radutvalg, minst 100 observasjoner per blad og rå klassevekt 1,0. Tidlig stopp brukte 100 iterasjoner uten forbedring i ROC-AUC på valideringssettet som stoppkriterium; beste iterasjon for seed 42 var 320. Hyperparametrene ble valgt i den forutgående utviklingsprosessen beskrevet i kapittel 3 — en prosess som ikke var blind for FY2024 — og deretter frosset før 10-seeds-kjøringen. Usikkerheten fra dette valget inngår ikke i de rapporterte konfidensintervallene.
Seeds 42–51 endret rad- og variabelsubsampling, mens datasplitten og alle øvrige kontrakter var konstante. Ensembleprediksjonen er gjennomsnittet av de ti modellprediksjonene. Dette reduserer seed-avhengig varians og gjør sammenlikningen mindre følsom for én heldig initialisering. Vi rapporterer både ensemblet og fordelingen av enkeltseeds. Ensemblet er den frosne modellen; gjennomsnittet av enkeltseed-metrikker er ikke det samme som metrikken beregnet på gjennomsnittsprediksjonen.
Modelltilpasning brukte ROC-AUC til tidlig stopp, men resultatvurderingen var flermetrisk. ROC-AUC måler sannsynligheten for at en tilfeldig positiv observasjon rangeres over en tilfeldig negativ. Ved 2,15 prosent prevalens kan ROC-AUC skjule lav presisjon, og PR-AUC er derfor et sentralt mål. Vi rapporterer i tillegg standardisert partiell ROC-AUC ved falsk-positiv-rate opptil 10 prosent, Brier-skår, log-loss, kalibreringshelning, kalibrering-i-det-store, forventet kalibreringsfeil og fangst ved faste undersøkelsesbudsjetter.
Sannsynlighetene ble kalibrert med en logistisk Platt-transformasjon estimert utelukkende i valideringssettet. Valideringssettet har dermed to roller: tidlig stopp for hvert ensemblemedlem og estimering av kalibratoren. Rollene deler de samme 765 utfallene, noe som kan gi en svakt optimistisk kalibrator. Siden nivåporten likevel feilet i FY2024, endrer ikke dette studiens dom, men en produksjonskalibrator bør estimeres på data som ikke også styrte tidlig stopp. Kalibrering endrer nivået og spredningen av sannsynlighetene, men ikke rangeringen når transformasjonen er monoton. Det er derfor mulig at ROC-AUC og PR-AUC er gode samtidig som den absolutte sannsynligheten er feil. Nettopp dette skjedde i FY2024 og behandles som et funn, ikke som en kosmetisk detalj.
p̄i = (1/10) Σs=4251 pi,s og logit(pi,kal) = αval + βval · logit(p̄i)Kanarivariabelen var deterministisk pseudotilfeldig og ble med i den frosne featurekontrakten. Det gjør auditsporet reproduserbart, men betyr også at den ikke bare var en ekstern diagnostikk: treet kunne prinsipielt splitte på den. Kanarien kan heller ikke avleses med gain-basert variabelviktighet: en kontinuerlig støyvariabel tilbyr alltid splittepunkter for en grådig trelærer og oppnår positiv gain uten å bære informasjon. En kanarikontroll på trær må derfor bruke permutasjonsviktighet eller et annet etikettbrytende mål. Den frosne kjøringen lagret ikke en slik avlesning, og kanariens bidrag kan følgelig ikke friskmeldes i ettertid (kapittel 10). En endelig distribuerbar modell må refittes og valideres uten kanarien. Resultatene i denne artikkelen beskriver den faktisk frosne 215-inngangsmodellen og skjuler ikke dette avviket.
6. Falsifikasjon og lekkasjeaudit
Begrepet «lekkasjefri» brukes ofte for løst. En kolonne kan være fri for selve etiketten og likevel bære et perfekt fingeravtrykk av fremtidig status. Vi definerte derfor lekkasje som enhver informasjonsvei der modellen får tilgang til hendelser, registertilstander, kildeproveniens eller seleksjonsmekanismer som ikke var tilgjengelige for den aktuelle virksomheten ved origin. Definisjonen omfatter også utvelgelsesprosedyren: en feltliste valgt med kjennskap til evalueringsetiketter er lekkasje, selv om hver enkelt kolonne isolert er punkt-i-tid-ren.
Auditregimet kombinerer statiske kontrakter og empiriske falsifikasjonstester. Statiske kontrakter avviser forbudte kilder, krever unik nøkkel per organisasjonsnummer og regnskapsår, kontrollerer at antall post-origin-rader er null, og hasher SQL, kode, featureorden og artefakter. Empiriske tester kontrollerer at duplikater ikke endrer resultatet, at fremtidige rader kan legges til uten å endre historiske features, at kildeflyt ikke har mistenkelig kalendervekst, og at selskapsspesifikke verdier mister kraft når de stokkes innen bevarte kilde- og tidsstrata.
Seks porter mellom offentlig råhendelse og modellvariabel
Alle daterte prediktorer må ha hendelsesdato på eller før 31. desember i det aktuelle FY. Målt antall post-origin-rader: null i de nye reviderte familiene.
Samtidige rolle- og eierbilder, utfallsavledet konkurshistorikk og kildeidentifikatorer er eksplisitt forbudt som modellinngang.
Samme logiske kunngjøring teller én gang. Kollisjoner og ukjent rekkefølge håndteres konservativt fremfor å gjette.
Donorer velges bare blant fit-selskaper, uten etikettlesing. Ingen kilde-, donor-, dekning- eller manglendehetsflagg når modellen.
Selskapsspesifikke regnskapsverdier stokkes mens kilde- og tidsmønster bevares. Tap av ytelse viser at verdiene, ikke bare proveniensen, bærer signal.
Featureorden, kjører, frysekontrakt og beviskvittering bindes kryptografisk. Seed 42 ga identisk prediksjonsvektor ved ny kjøring.
Portene er ikke teoretiske forsiktighetsregler; hver svarer på en feilklasse som faktisk oppstod og ble målt under utviklingen. Forbudet mot samtidige rollebilder (port 02) stammer fra en identitetsnøkkel som var disambiguert mot et senere registerbilde og dermed bar overlevelsesinformasjon inn i persongrafen. Forbudet mot kilde- og dekningsflagg (port 04) stammer fra en sentinelverdi og geografiske indikatorer som i praksis identifiserte innsamlingskanalen for gjenvunne, overveiende avviklede selskaper. Retensjonsskjermen og forbudet mot konkursavledet historikk stammer fra variabler som vokste med kildens slettevindu i stedet for med selskapsrisiko. Den stratifiserte omstokkingen (port 05) stammer fra en variabelfamilie der kontrollarmer viste at hele bidraget lå i tilgjengelighetsmønsteret, ikke i verdiene. Kravet om frosne kontrakter på begge sider av en sammenlikning stammer fra én variabelutvelgelse som hadde lest evalueringsårets etiketter, og én lagret referanseprediksjon med en annen kolonnekontrakt enn den gyldige komparatoren.
Punkt-i-tid- og duplikatporter
Kapital-, aktualitets- og personnettverksbyggerne rapporterte null post-origin-rader, full nøkkeldekning og unike organisasjonsnummer–FY-nøkler. Aktualitets- og kapitalfamiliene bestod fremtidsappend-test: dersom senere kilderader legges til, skal tidligere selskapsår forbli bitmessig uendret. Begge familiene bestod også logiske duplikattester. Dette er sterkere enn å skrive en datobetingelse i SQL; testen utfordrer om betingelsen faktisk beskytter den ferdige artefakten.
Retensjon ble kontrollert ved å sammenlikne kildeflyt og featurefordelinger fra FY2021 til FY2024. En symmetrisk vekst over 1,5 ganger utløser mistanke om kalender- eller retensjonssignal. De valgte nye familiene bestod denne skjermen. En revisornettverksrate med svakere metodisk grunnlag ble uttrykkelig utelatt, selv om den kunne ha forbedret et utviklingstall. Negative og forkastede resultater er en del av modellens evidens, fordi de viser at variabeltilgang ikke automatisk førte til opptak.
Negativ kontroll for regnskapsblokken
Den største residuale bekymringen var at historiske regnskapsverdier kom fra flere gjenfinningslag. Dersom «hvor verdien kom fra» var korrelert med senere utfall, kunne modellen lære kilden i stedet for økonomien. I en forhåndsdefinert ett-seeds-falsifikasjon ble hele den 57-variablers historiske regnskaps- og kvalitetsblokken stokket samlet mellom selskaper innen strata som bevarte regnskapsår, næring og observerbarhetsmønster. 709 772 rader ble flyttet til et annet selskap, uten etikettlesing.
Den ekte blokken slo kontrollen med +0,04143 ROC-AUC, +0,16523 PR-AUC og 839 flere treff i topp 1 prosent. Det er ikke et fullstendig kausalitetsbevis, men det tilbakeviser en enkel forklaring der hele regnskapsbidraget bare skyldes kilde- eller dekningsmønster. En uavhengig paneljustering av 14 sentrale regnskapsmål viste dessuten om lag 99,4–99,9 prosent enighet innen toleransen maks(1 000 kroner, 0,1 prosent) på overlappende observasjoner. For variabelfamilier med lav dekning ble det i utviklingen i tillegg brukt kontrollarmer der bare tilgjengelighetsmasken, stokkede verdier med bevart manglendemønster eller placebokopier av eksisterende felt ble tilbudt modellen; en familie der masken alene reproduserte hele gevinsten, ble forkastet før frysing. Omstokkingskontrollen i dette kapitlet er den frosne, forhåndsdefinerte varianten av samme prinsipp.
Eksakt replay og uforanderlige kvitteringer
Den endelige kjøringen lagret én beviskvittering, ikke alle mellomliggende boostere og prediksjonsfiler. Koden, featureordenen, frysingen og inndataartefaktene ble bundet med SHA-256. Seed 42 ble deretter kjørt på nytt med samme kontrakt. Beste iterasjon var 320 i begge kjøringer, den maksimale absolutte forskjellen mellom evalueringsprediksjonene var 0,0, og prediksjonshashen var identisk.
7. Resultater: diskriminering og inkrementell verdi
Det frosne 10-seeds-ensemblet oppnådde ROC-AUC 0,883 og gjennomsnittlig presisjon (AP) 0,411 i FY2024. Standardisert partiell ROC-AUC ved falsk-positiv-rate opptil 10 prosent — skalert slik at 0,5 tilsvarer tilfeldig og 1,0 perfekt rangering innenfor dette området — var 0,768. Brier-skåren etter valideringsbasert kalibrering var 0,0161, og log-loss var 0,0724. Til sammenlikning gir en informasjonsløs modell som alltid predikerer prevalensen en Brier-skår på p(1 − p) = 0,021050; den lave absolutte Brier-verdien reflekterer først og fremst lav prevalens og må leses relativt til denne, ikke som selvstendig bevis på god kalibrering. Tallene er beregnet på den samme evalueringspopulasjonen med 375 688 selskaper og 8 082 observerte utfall. Tabellene og metodegrunnlag.json oppgir full presisjon; løpende tekst er avrundet til tre–fire desimaler.
AP er brukt fordi utfallet er sjeldent. En tilfeldig rangering har forventet presisjon nær prevalensen — andelen selskaper med observert utfall i vinduet, 8 082/375 688 = 0,021513. En AP på 0,411 betyr ikke at alle selskaper over en gitt terskel har 41 prosent risiko; det er et rangeringsovergripende mål som summerer presisjon ved ulike sensitivitetsnivåer. Absolutt sannsynlighet må vurderes med kalibreringsmålene i neste avsnitt.
| Mål | Referanse, 198 | Kandidat, 215 | Forskjell |
|---|---|---|---|
| ROC-AUC | 0,879204 | 0,882950 | +0,003746 |
| Gjennomsnittlig presisjon (AP) | 0,398033 | 0,411187 | +0,013153 |
| Standardisert partiell AUC, FPR ≤ 10 % | 0,761633 | 0,768019 | +0,006387 |
| Brier-skår | 0,016343 | 0,016147 | −0,000195 |
| Treff i topp 1 % | 2 333 | 2 352 | +19 |
| Treff i topp 5 % | 4 404 | 4 514 | +110 |
| Treff i topp 10 % | 5 335 | 5 417 | +82 |
Parret selskapsbootstrap
For å isolere forskjellen mellom kandidat og referanse ble begge modellene evaluert på de samme selskapene, og det samme selskapsutvalget ble brukt for begge modeller i hvert av 1 000 bootstrap-trekk. FY2024 har én rad per selskap, slik at selskapsklyngen og raden er identiske i denne kohorten. Intervallene er persentilintervaller fra den parrede differansefordelingen. De er ikke justert for at syv mål rapporteres samtidig; de skal leses som parvise 95-prosentintervaller per mål, ikke som simultan dekning for hele settet, og ingen enkeltkonklusjon i studien hviler på det svakeste av flere intervaller. Intervallene betinger dessuten på de to frosne modellene og uttrykker bare utvalgsusikkerhet i evalueringskohorten; usikkerhet fra ny modelltilpasning — andre seeds eller treningsutvalg — inngår ikke. Brier-forbedringen var +1,95 × 10⁻⁴ (95 prosent konfidensintervall +1,49 til +2,43 × 10⁻⁴); den rapporteres her i teksten fordi den på figurens prosentpoengakse ville vært et uleselig punkt.
Kandidaten forbedrer de fleste mål; topp 1 prosent krysser null
Risikokonsentrasjon ved fast undersøkelseskapasitet
En risikomodell brukes ofte som prioriteringsverktøy: hvor mange reelle hendelser kan undersøkes når organisasjonen bare har kapasitet til å gjennomgå en begrenset andel av foretaksbestanden? Kandidaten fanget 2 352 utfall blant de 3 756 høyest rangerte selskapene. Det tilsvarer 62,62 prosent presisjon og 29,10 prosent sensitivitet; presisjonen var dermed 29,11 ganger prevalensen (løft 29,11). Ved fem prosent kapasitet ble 4 514 utfall fanget; ved ti prosent ble 5 417 fanget.
Andel observerte utfall fanget ved tre kontrollbudsjetter
Stabilitet på tvers av seeds
Enkeltmodellene hadde gjennomsnittlig ROC-AUC 0,8781 med standardavvik 0,0012 og gjennomsnittlig AP 0,3934 med standardavvik 0,0030. Ensemblet var bedre enn hvert enkelt medlem på begge rangeringsmålene. Dette er forventet når gjennomsnittet reduserer idiosynkratisk variasjon mellom trærne, men viser også hvorfor ensemblemetrikken ikke må forveksles med gjennomsnittet av seed-metrikkene.
Ti enkeltseeds og det frosne ensemblet
8. Kalibrering, økonomisk nytte og den porten som feilet
Diskriminering svarer på hvem som bør rangeres høyere. Kalibrering svarer på om «tre prosent risiko» faktisk betyr omtrent tre hendelser per hundre sammenliknbare selskaper. Det skillet er avgjørende i kredittbruk. En dårlig kalibrert modell kan fortsatt prioritere kontroller effektivt, men den bør ikke brukes direkte som prisingsgrunnlag, tapsestimat eller absolutt misligholdssannsynlighet.
I FY2024 var observert hendelsesandel 2,151 prosent, mens gjennomsnittlig kalibrert prediksjon var 1,327 prosent. Observert/forventet-forholdet var dermed 1,62: samlet observert risiko var 62 prosent høyere enn forventet av modellen. Kalibrering-i-det-store — interceptet i en logistisk rekalibrering av prediksjonene, målt på logit-skala — var +0,6616 og brøt den låste grensen |CITL| ≤ 0,25. Samtidig var kalibreringshelningen 0,9638 innenfor intervallet 0,7–1,3, og forventet kalibreringsfeil med ti intervaller (ECE10) 0,00825 innenfor grensen 0,01. Modellen hadde altså rimelig relativ spredning, men feil samlet nivå.
Fordi prediksjonene er frosne og modningen frem til 31. desember 2026 bare kan legge til observerte hendelser, er O/E-forholdet på 1,62 en nedre grense for det fullt modne vinduet: nevneren ligger fast, telleren kan bare vokse. Underprediksjonen av samlet nivå vil bestå eller forsterkes ved modning, aldri forsvinne. Diskriminerings- og AP-tallene kan derimot flytte seg i begge retninger.
To kalibreringsporter bestod; nivåporten feilet
Som prioriteringsmodell konsentrerte kandidaten utfall bedre enn tilfeldig prioritering ved terskler fra én til tjue prosent i den lagrede analysen, men en slik analyse alene kan ikke fastsette en forretningsregel. Kostnaden ved falsk positiv, tapet ved oversett konkurs, saksbehandlingskapasitet og krav til forklarbarhet må defineres av den konkrete bruken. Den praktiske konklusjonen er derfor todelt: rangeringen kan prøves i kontrollert skyggetesting; sannsynligheten må rekalibreres og overvåkes før den inngår i prising eller kredittgrenser.
9. Undergrupper og hvor modellen er svakere
Gjennomsnittlig ytelse kan skjule segmenter der rangeringen er vesentlig dårligere. Aldersanalysen viser størst svakhet blant selskaper yngre enn to år: ROC-AUC 0,781. For selskaper mellom to og fem år var ROC-AUC 0,877, og for selskaper mellom ti og tjue år 0,906. AP varierer også, men påvirkes direkte av forskjeller i hendelsesprevalens mellom gruppene og kan ikke sammenliknes uten kontekst; hendelsesandelen per gruppe er derfor tatt inn i tabellen.
| Selskapsalder | Selskaper | Utfall | Hendelsesandel | ROC-AUC | AP |
|---|---|---|---|---|---|
| Under 2 år | 54 672 | 1 691 | 3,09 % | 0,780867 | 0,288329 |
| 2 til under 5 år | 79 114 | 2 373 | 3,00 % | 0,876846 | 0,554010 |
| 5 til under 10 år | 88 435 | 2 149 | 2,43 % | 0,894929 | 0,420735 |
| 10 til under 20 år | 95 375 | 1 327 | 1,39 % | 0,906428 | 0,365802 |
| 20 år eller mer | 58 092 | 542 | 0,93 % | 0,895068 | 0,291086 |
Blant næringsdivisjoner med minst 1 000 selskaper og 20 utfall varierte ROC-AUC fra om lag 0,797 til 0,934. Verken alders- eller næringsestimatene har egne bootstrapintervaller i den frosne kvitteringen; forskjeller mellom nabogrupper skal derfor leses som deskriptive. Undergruppetallene skal brukes som heterogenitetssignaler, ikke som en rangering av hvilke segmenter modellen «behersker». Før produksjonsbruk må det defineres minimumsstørrelser, kalibrering per segment og en fallback for grupper der usikkerheten er høy.
Yngste selskaper har både kort regnskapshistorikk og færre daterte administrative hendelser. Den lavere AUC-en er derfor mekanistisk plausibel: de viktigste datakildene har rett og slett hatt mindre tid til å observere selskapet. Et produkt som presenterer én risikoscore bør synliggjøre denne informasjonsbegrensningen og ikke gi samme sikkerhetsinntrykk for et ett år gammelt selskap som for et ti år gammelt.
10. Begrensninger og gjenstående bevis
For det første er FY2024-utfallet ikke fullt modent. Den administrative avlesningen stopper 24. august 2026, mens et fullstendig 24-månedersvindu etter 31. desember 2024 lukkes 31. desember 2026. Selskaper som svikter i de siste månedene er foreløpig behandlet som uten observert utfall. Hovedresultatet må derfor oppdateres når vinduet er komplett; særlig AP kan flytte seg når flere positive hendelser registreres, mens nivåfeilen i kapittel 8 bare kan bestå eller forsterkes.
For det andre er FY2024 tidsmessig holdt ut, men ikke uberørt. Evalueringsåret ble sett flere ganger i den bredere utviklingsprosessen. Den parrede bootstrapen er gyldig for den frosne kandidaten mot den frosne referansen på denne kohorten, men kan ikke korrigere optimisme fra alle tidligere valg. Det delte utfallsvinduet mellom siste utviklingsårgang og FY2024 (kapittel 3) kommer i tillegg: den frosne kjøringen purget ikke overlappende rader, og overlappet trekker i retning av et noe for gunstig evalueringsresultat. Neste sterke bevis er en forhåndsregistrert tidskohort som ikke åpnes før alle designvalg er låst, eller en uavhengig portefølje med samme origin- og utfallsdefinisjon.
For det tredje er regnskapsklokken sikret ved FY−1-regel og før-origin-godkjenningsspor, men den frosne beviskjeden har ikke dokumentnivå innsendings-, publiserings- og revisjonstidspunkt for hver enkelt historisk verdi. Kildejustert omstokking og høy enighet med et uavhengig panel reduserer mistanken om at hele signalet er provenance, men erstatter ikke full dokumentbundet punkt-i-tid-proveniens. Påstanden vår begrenses derfor til lekkasjeresistens under de implementerte testene.
For det fjerde ble proof-kjøringen produsert med en eldre etikett-SQL enn den senere kronologisk korrigerte versjonen. En read-only-sammenlikning fant åtte færre kvalifiserte FY2022-rader, hvorav seks utfall, og fire færre FY2024-rader, alle utfall, i den korrigerte kronologien. Ingen felles rad skiftet hendelsesstatus. Forskjellen er liten relativt til 375 688 evalueringer, men en streng endelig reproduksjon må binde modellen til den korrigerte etikettkoden og kjøre den frosne analysen på nytt.
For det femte ble den deterministiske kanarien stående som modellinngang. Dens endelige betydning ble ikke lagret, og den kan derfor ikke erklæres irrelevant i ettertid — og som kapittel 5 viser, ville en gain-basert avlesning uansett ikke kunne ha friskmeldt den. Den deployerbare arkitekturen må refittes uten kanarien og vise at ytelsen og bootstrapkonklusjonene består. Tilsvarende har personnettverket et åpent spørsmål om fullstendigheten av negative kanter: en positiv hendelsestabell kan bevise observerte forbindelser, men ikke alltid at fravær av forbindelse betyr reelt fravær.
For det sjette er den frosne leveransen en metrikk- og arkitekturkvittering, ikke en komplett produksjonspakke. Mellomliggende boostere, prediksjonsvektorer, treningsmatrise og bootstrap-trekk ble med vilje ikke lagret for å begrense artefaktvekst. Det var riktig for en utviklingsaudit, men betyr at en deployerbar modellfil, avhengighetslås, skåringskontrakt, overvåkningsregime og driftstest må bygges separat. Reliability-bin-data ble heller ikke lagret, så en full reliabilitetskurve kan ikke tegnes fra den endelige kvitteringen uten en ny bundet prediksjonsartefakt.
For det syvende er absolutt kalibrering utilstrekkelig, og ytelsen er heterogen. En AUC på 0,781 blant de yngste selskapene kan være for svak for enkelte beslutninger. Produksjonsbruk krever derfor formålsbestemt terskelvalg, segmentanalyse, rekalibrering, monitorering av populasjons- og prevalensdrift og en tydelig menneskelig overstyringsprosess. Modellen er ikke validert for andre organisasjonsformer, andre land, alle typer selskapsopphør eller regulatorisk kapitalkrav.
Til slutt kan ingen intern studie etablere at modellen «slår banker» eller navngitte kredittopplysningsaktører uten identiske selskaper, origin-datoer, utfall, modenhet og målekriterier. Slike sammenlikninger krever en felles blind test. Vår målbare påstand er smalere og sterkere: i den definerte FY2024-kohorten rangerte den frosne kandidaten de observerte utfallene godt og slo sin frosne referanse på de forhåndsrapporterte hovedmålene.
| Påstand | Evidens | Dom |
|---|---|---|
| Sterk rangering i FY2024 | AUC 0,882950; AP 0,411187; topp-5-sensitivitet 55,85 % | Støttet i observert kohort |
| Bedre enn frosset referanse | Parrede intervaller over null for AUC, AP, partiell AUC, Brier og topp 5/10 % | Støttet, betinget på sammenlikningen |
| Topp 1 % er signifikant bedre | Δ sensitivitet +0,246 pp (punktdifferanse +0,235 pp); CI −0,210 til +0,691 | Ikke etablert |
| Lekkasjefri i absolutt forstand | Omfattende tester, men residual regnskaps- og etikettproveniens og delt utfallsvindu | Kan ikke bevises absolutt |
| Ferdig 24-måneders sannsynlighet | O/E 1,6216 (nedre grense under modning); CITL-port feilet; kohorten er umoden | Ikke støttet |
| Produksjonsklar modellpakke | Ingen deployerbar booster eller komplett skåringspakke i kvitteringen | Ikke ennå |
11. Konklusjon
Byggsikt Risiko 24 viser at egenkuraterte offentlige norske register-, regnskaps- og kunngjøringsdata kan gi sterk, praktisk nyttig rangering av konkurs og tvangsoppløsning. På 375 688 FY2024-selskaper med 8 082 observerte utfall oppnådde 10-seeds-ensemblet ROC-AUC 0,883 og AP 0,411. De fem prosent høyest rangerte selskapene inneholdt 4 514 av utfallene. Forbedringen mot den frosne 198-variabelreferansen var positiv med parrede 95-prosentintervaller for AUC, AP, partiell AUC, Brier og sensitivitet ved fem og ti prosent kapasitet.
Den viktigste vitenskapelige verdien er likevel ikke ett desimaltall. Den ligger i at flere attraktive resultater ble trukket tilbake da de viste seg å være drevet av kohortseleksjon, feil klokke, kildeproveniens, kalendervariabler eller manglendehetsmønster. Den valgte modellen står igjen etter tidsporter, kildeforbud, de-duplisering, fit-only-imputasjon, negative omstokkingskontroller, hashbinding og bit-eksakt replay.
Domsslutningen er presis: Modellen er en sterk og reproduserbar utviklingskandidat for risikorangering og kontrollert skyggetesting. Den er ikke ennå en ferdig kalibrert sannsynlighetsmodell eller en autonom kredittbeslutning. Før en slik bruk må FY2024-vinduet modnes, den korrigerte etikettkoden bindes, kanarien fjernes, sannsynligheten rekalibreres og en deployerbar pakke valideres på en ny låst kohort. Å rapportere disse grensene er ikke å svekke modellen. Det er det som gjør resultatet forsvarlig.
Sitering, versjon og erklæringer
Slik siterer du denne studien
Byggsikt Data. «Tidsriktig prediksjon av konkurs og tvangsoppløsning i norske aksjeselskaper: utvikling, adversarial revisjon og ut-av-tid-validering av en 24-måneders risikomodell.» Byggsikt, 29. august 2026. Foreløpig valideringsstudie, versjon 1.0. https://www.byggsikt.no/rad/konkursrisiko-norske-smaforetak/
@techreport{byggsikt2026risiko24,
  author      = {{Byggsikt Data}},
  title       = {Tidsriktig prediksjon av konkurs og tvangsoppl{\o}sning i norske aksjeselskaper},
  institution = {Byggsikt},
  year        = {2026},
  month       = {8},
  type        = {Forel{\o}pig valideringsstudie, versjon 1.0},
  url         = {https://www.byggsikt.no/rad/konkursrisiko-norske-smaforetak/},
  note        = {Beviskvittering SHA-256 333a0762d10ba574...; tallgrunnlag i metodegrunnlag.json}
}
Versjon og status
Versjon 1.0, publisert 29. august 2026. Studien er en foreløpig valideringsstudie: FY2024-utfallet er høyresensurert til 31. desember 2026, og hovedtallene oppdateres i en versjon 1.1 når vinduet er komplett. Alle hovedresultater og sammenlikningstall er gjengitt i metodegrunnlag.json. Enkelte prosess- og falsifikasjonstall — blant annet omstokkingskontrollen og paneljusteringen i kapittel 6, retensjonsskjermen, arkitekturparametrene i kapittel 5, undergruppespennet i kapittel 9 og etikett-SQL-avviket i kapittel 10 — finnes foreløpig bare i den SHA-256-bundne beviskvitteringen og er ikke selvstendig etterprøvbare fra evidensfilen; de tas inn i en utvidet metodegrunnlag.json i versjon 1.1. Endringer skjer bare gjennom nye, daterte versjoner av denne siden.
Interessekonflikter og finansiering
Studien er utført og finansiert av Byggsikt, som utvikler modellen den beskriver, til bruk i egne tjenester. Det er en åpenbar egeninteresse i et positivt resultat. Motvekten er metodisk og eksplisitt: forhåndsdefinerte porter som fikk lov til å feile og rapporteres som feilet, parrede konfidensintervaller også der de svekker konklusjonen, negative kontroller, og en dom som avgrenser bruken til rangering og skyggetesting. Ingen eksterne oppdragsgivere har påvirket design eller rapportering.
Datatilgjengelighet
Det saniterte tallgrunnlaget er offentlig i metodegrunnlag.json og bundet til publikasjonen med kryptografiske fingeravtrykk. Rådata stammer fra offentlig tilgjengelige norske registerkilder; Byggsikts innsamlings- og tolkningsinfrastruktur er proprietær og publiseres ikke. Ekstern fullreproduksjon er derfor begrenset, og dette oppgis som en eksplisitt avgrensning i § 10.
Referanser og metodekilder
- Brønnøysundregistrene. Om Regnskapsregisteret. Offentlighet, innsendingsforløp og ordinær frist for årsregnskap.
- Brønnøysundregistrene. Kunngjøringer fra Konkursregisteret. Innhold og publisering av konkurs- og tvangsoppløsningskunngjøringer.
- Brønnøysundregistrene. Enhetsregisterets dokumentasjon for åpne data. Tekniske tjenester, datafelt og offentlig lisens.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. TRIPOD-erklæringen. BMJ. 2015;350:g7594.
- Moons KGM mfl. PROBAST+AI. Oppdatert verktøy for kvalitet, risiko for skjevhet og anvendelighet i prediksjonsmodeller.
- Saito T, Rehmsmeier M. The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets. PLOS ONE. 2015;10(3):e0118432.
- Van Calster B mfl. Calibration: the Achilles heel of predictive analytics. BMC Medicine. 2019;17:230.
- Efron B, Tibshirani RJ. An Introduction to the Bootstrap. Chapman & Hall/CRC; 1993.
- Friedman JH. Greedy Function Approximation: A Gradient Boosting Machine. Annals of Statistics. 2001;29(5):1189–1232.
Hovedresultatene i denne publikasjonen er bundet til den saniterte offentlige evidensfilen; prosess- og falsifikasjonstallene er bundet til beviskvitteringen i § 6. Kildekode, rådata og enkelte innsamlingsprosedyrer er ikke publisert fordi de inngår i Byggsikts proprietære datainfrastruktur. Det begrenser ekstern fullreproduksjon og oppgis derfor som en eksplisitt avgrensning.